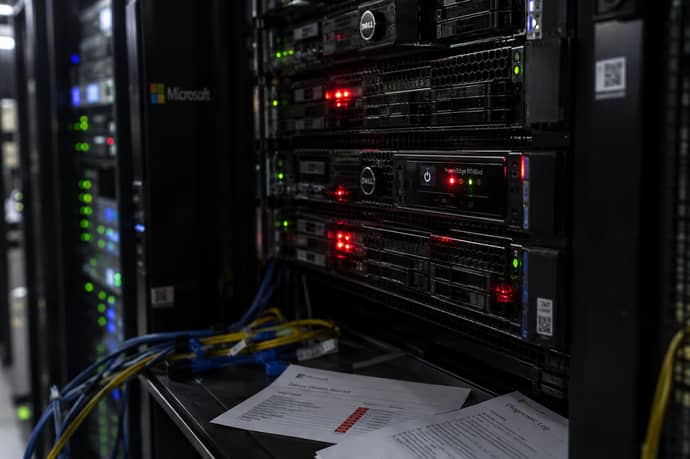
Da giovedì Outlook, Teams e Copilot vanno a intermittenza e il down Microsoft non è ancora chiuso: server riavviati, traffico spostato, nessun orario di fine. Non è un attacco hacker. Ecco cosa si sa.
Il blackout dei servizi Microsoft 365 iniziato giovedì 12 novembre 2026 non è ancora chiuso oggi venerdì 13 novemnbre 2026 mentre stiamo scrivendo. Microsoft ha riavviato parte dei server, deviato il traffico su altre infrastrutture e sta preparando sistemi automatici per riportare online le macchine che non rispondono. Finora però non ha dichiarato l’incidente risolto e non ha dato un orario di fine. Il ripristino è graduale e a macchia di leopardo: per alcuni utenti Outlook torna a funzionare, per altri no.
Quando è iniziato e quanto è stato grave
I primi problemi sono comparsi giovedì, intorno alle 13:00 ora della costa orientale degli Stati Uniti. Gli utenti non riuscivano più a collegarsi alle caselle Exchange Online, a prescindere dal metodo: Outlook sul web, client desktop, app mobile e API REST. Cambiare programma non serviva, perché a cedere era il servizio a monte.
Downdetector ha registrato un picco di quasi 130.000 segnalazioni per Outlook, oltre 25.000 solo negli Stati Uniti secondo Reuters. Si tratta di segnalazioni degli utenti e non del numero di aziende colpite. Microsoft 365 nel suo insieme ha superato le 38.000 segnalazioni e Teams circa 4.500. Nella mattina italiana di venerdì 13 novembre, intorno alle 7:30, le segnalazioni dall’Italia erano più di mille.
Microsoft ha tracciato il problema con due codici: EX1550543 per la connettività alle caselle Exchange Online e MO1550821 per l’elenco dei servizi e delle funzioni coinvolti. Un terzo incidente, TM1550488, relativo a Teams nelle Americhe, risulta invece chiuso.
Quali servizi sono coinvolti
Oltre a Outlook, i disservizi hanno riguardato:
- Teams, soprattutto calendario e riunioni, mentre la messaggistica di base ha funzionato in gran parte; alcune cronache parlano di ore di interruzione, e le segnalazioni su Teams sono state molto meno numerose di quelle su Outlook;
- SharePoint Online, per le funzioni legate a Exchange;
- Copilot, compresa la chat di Copilot, che dipende dall’accesso ai dati di posta;
- Defender XDR, Purview e altri servizi di sicurezza e conformità;
- Planner, To Do, Intune e Defender for Office 365, secondo i resoconti che ripercorrono gli avvisi di Microsoft;
- l’accesso alla posta tramite Microsoft Graph.
Gli effetti fuori dall’ufficio
Il guasto ha toccato anche istituzioni e aziende tecnologiche. Secondo le cronache internazionali, tra i colpiti ci sono la Camera dei Rappresentanti degli Stati Uniti, un’agenzia di intelligence australiana e la polizia federale australiana. Anche i servizi che si collegano a Microsoft 365 hanno avuto problemi: OpenAI ha dichiarato di indagare su un’anomalia legata a un connettore Microsoft, e Anthropic ha segnalato un problema presso un fornitore a monte che riguardava il proprio connettore per M365.
Il ministro degli Interni australiano, Tony Burke, ha riferito che Microsoft vede l’episodio come simile a quello di CrowdStrike, cioè un aggiornamento che ha provocato problemi imprevisti. Il paragone è del ministro, riportato dalla stampa, e non una conclusione ufficiale di Microsoft.
Che cosa dice Microsoft sulle cause
Nelle comunicazioni pubblicate finora, la spiegazione si è affinata per gradi.
Prima fase: carico anomalo. Microsoft ha parlato di squilibri persistenti nella gestione del traffico. Ha poi precisato che non c’era stato un aumento del traffico: a creare il problema era un numero di server diventati «unexpectedly unavailable», cioè indisponibili in modo imprevisto. Il lavoro dei server caduti ricadeva su quelli ancora attivi, che si sovraccaricavano a loro volta.
Seconda fase: i controlli di integrità. I server fallivano gli health check automatici, i controlli che decidono se una macchina può restare in servizio. Un server che non li supera viene escluso, e il carico sugli altri aumenta. Microsoft ha ipotizzato un legame con un componente di questi controlli.
Terza fase: il processo sulle connessioni sicure. Secondo quanto riferito dalle cronache, Microsoft ha spiegato giovedì sera che un processo sui server coinvolti, responsabile di stabilire le connessioni sicure, si sovraccarica e porta i server a non elaborare più le richieste.
Il nodo della modifica di configurazione. All’inizio Microsoft non aveva collegato il guasto a una modifica recente. Dopo, ha annunciato il ritiro di una modifica alla configurazione di rete che «sembra correlata» con l’inizio del problema. Su questo punto le fonti non coincidono del tutto: alcune ricostruzioni ricordano che nessuna modifica era stata identificata, altre che il rollback è in corso. Una causa radice definitiva non è stata confermata. Microsoft ha poi escluso che si tratti di un attacco informatico.
Che cosa ha fatto Microsoft per rimettere in piedi il servizio
Le azioni dichiarate sono numerose e vanno in direzioni diverse:
- Sospensione dei deployment e delle modifiche di configurazione, per non aggiungere variabili durante l’emergenza.
- Spostamento del traffico su altre parti dell’infrastruttura globale, isolando di nuovo una porzione di quella colpita.
- Riavvio dei server non responsivi.
- Limitazione temporanea di alcuni tipi di traffico in determinate località, per evitare che i server appena tornati online vengano subito travolti.
- Metodo alternativo di verifica dello stato dei server, che ha riportato online alcune macchine e che Microsoft sta estendendo a più server.
- Test di una modifica ai controlli di integrità e valutazione del rollback di alcuni aggiornamenti di configurazione.
- Sistemi automatici per individuare e riavviare i server che smettono di rispondere.
A che punto siamo adesso
Gli ultimi aggiornamenti disponibili, fino alla notte tra giovedì e venerdì e alla mattina del 13 novembre, descrivono una situazione ancora in evoluzione. Microsoft cercava di «aprire tutti i percorsi disponibili per ripristinare il servizio». Alcune aree hanno visto miglioramenti, ma il quadro resta disomogeneo, e le testate che seguono il caso, tra cui Open e Alanews, non riportano un ripristino completo.
Il punto è che non esiste una stima ufficiale dei tempi. Per questo, nel titolo, parliamo di tempi ancora incerti: Microsoft indica che il servizio tornerà gradualmente, senza impegnarsi su una data.
Che cosa possono fare utenti e amministratori
Per chi gestisce un tenant Microsoft 365 le indicazioni pratiche sono queste:
- controllare Service health nell’interfaccia di amministrazione e seguire gli incidenti EX1550543 e MO1550821; servono i ruoli di amministratore del supporto o dell’helpdesk;
- se l’interfaccia di amministrazione non è raggiungibile, usare la pagina di stato pubblica o l’account X di Microsoft 365 Status;
- evitare ticket di supporto duplicati per problemi già elencati;
- prevedere un ripristino non uniforme: Outlook può funzionare per un collega e non per un altro;
- avvisare gli utenti di possibili tentativi di phishing e false telefonate di supporto che approfittano del down. Microsoft non telefona per riparare le caselle di posta.


Marcello Tansini
Nato a Milano nel 1979, laureato alla Bocconi dopo il liceo classico ai Salesiani di Milano. Uno dei pionieri dell'Internet italiano, uno dei fondatori tra l'altro del celebre sito degli anni 90-2000 webmasterpoint.org, si occupa di organizzare tutta la parte editoriale di Businessonline, ma scrive anche lui stesso sia sulle tematiche legate ai suoi studi che alle sue passioni. In modo particolar...
 Seguici su Google News cliccando qui e poi fai click sulla Stellina in alto a destra