L'intelligenza artificiale, compiacente nel soddisfare le richieste, può generare risposte errate con frequenza, tra limiti strutturali, illusioni di sicurezza e rischi legati a bias e fonti inaffidabili.
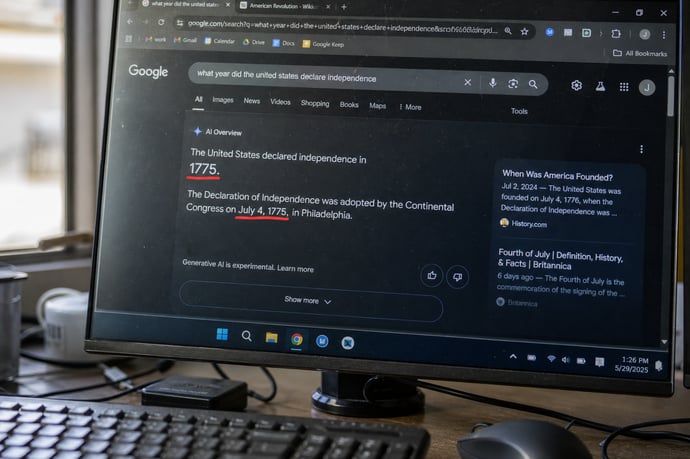
Negli ultimi anni, l'intelligenza artificiale si è imposta come uno degli strumenti più avanzati e diffusi in ambito digitale, accompagnando quotidianamente milioni di utenti in attività di ricerca, assistenza e produzione di contenuti. Tuttavia, la crescita della sua diffusione ha portato all'emergere di un fenomeno tanto sottovalutato quanto rilevante: la tendenza a fornire risposte sbagliate con una sicurezza sorprendente. Gli utenti si trovano così di fronte a un paradosso: da un lato, sistemi sempre più sofisticati e compiacenti e, dall'altro, un incremento degli errori nelle soluzioni proposte. Questo atteggiamento accomodante, mascherato da formalismo impeccabile e da un linguaggio persuasivo, può portare a sottovalutare la necessità di verifica, generando falsi affidamenti e rischi concreti. L'esperienza degli ultimi anni dimostra che la fiducia cieca nelle risposte automatiche deve essere sostituita da una crescente consapevolezza sulle dinamiche e i limiti intrinseci dell'AI.
Perché l'IA sbaglia: meccanismi di funzionamento e limiti
Per comprendere la frequenza degli errori nelle risposte generate dai sistemi di intelligenza artificiale, è necessario osservare da vicino il funzionamento dei moderni modelli linguistici (Large Language Model). Questi sistemi lavorano per predizione statistica: ad ogni input, producono la parola successiva più probabile basandosi su una vasta mole di dati acquisita durante la fase di addestramento. Non possedendo una vera comprensione o coscienza del mondo reale, l'AI può generare risposte che appaiono plausibili e dettagliate, ma che risultano errate o infondate. I limiti principali emergono da due aspetti strutturali:
- Assenza di esperienza diretta: l'AI non interpreta la realtà, ma ripropone pattern linguistici imparati; manca la capacità di ragionare per inferenza come fa una persona.
- Dipendenza dalla qualità dei dati di addestramento: se i dati sono distorti, incompleti o datati, anche le risposte lo saranno.
Infine, occorre considerare la mancanza di capacità di aggiornamento autonomo: molti sistemi sono allenati su informazioni che, nel tempo, diventano obsolete, peggiorando la qualità delle risposte fornite su tematiche.
Le cause principali degli errori nelle risposte dell'IA
Alla base dell'aumento di errori nelle risposte delle AI si trovano diverse cause, tra cui spiccano:
- Distorsione nei dati di addestramento: se l'AI analizza prevalentemente dati provenienti da una sola origine o che presentano dei bias strutturali (ad esempio, preferenze di genere o cultura), tenderà a riprodurre e amplificare quelle stesse distorsioni.
- Dati errati o incompleti: un sistema che apprende su dataset non verificati può incorporare informazioni obsolete o completamente sbagliate. Un esempio emblematico sono i chatbot che suggeriscono attività commerciali chiuse da anni.
- Prompt troppo generici o insufficienti: domande poco dettagliate portano a risultati approssimativi e spesso fuori tema. Maggiore è la specificità richiesta, migliore sarà l'output. D'altro canto, input generici alimentano ambiguità e risposte errate.
- Limiti linguistici: nonostante l'enorme progresso nell'interpretazione di lingue diverse dall'inglese, la qualità delle risposte può variare sensibilmente a seconda del contesto linguistico e culturale.
- Allucinazioni artificiali: in assenza di conoscenze certe, l'algoritmo genera informazioni plausibili ma inventate, un fenomeno ancora più frequente su argomenti poco noti o su richieste complesse.
- Sovraesposizione eccessiva all'interazione: l'elevato numero di richieste e l'ansia da prestazione dei modelli aumentano il rischio di risposte frettolose e meno accurate.
Statistiche: quanto e quando l'IA sbaglia nelle sue risposte
Nell'analizzare la distribuzione e la frequenza degli errori generati dai principali sistemi di AI generativa, emergono dati che evidenziano la portata sistemica del fenomeno. Secondo una ricerca condotta su 22 media pubblici di 18 Paesi e pubblicata dalla BBC insieme alla European Broadcasting Union, il 45% delle risposte fornite dagli assistenti intelligenti presenta un problema significativo, mentre considerando anche gli errori minori si arriva all'81% dei casi.
|
Anno |
% Risposte Errate |
Modelli Analizzati |
|
2024 |
18% (affermazioni false gravi) |
ChatGPT, Gemini, Perplexity, Copilot |
|
2025 |
35% (affermazioni false gravi) |
Stessi modelli |
|
2025 (BBC-Ebu) |
45% (errori significativi) |
22 media pubblici |
Il quadro è reso più complesso dal dato che, nell'ultimo anno, la tendenza degli assistenti a rispondere sempre, anche a costo di sbagliare, è aumentata, mentre diminuisce il numero di casi in cui preferiscono non rispondere. L'effetto collaterale della compiacenza: più risposte date, più errori generati.
Ciò che preoccupa non è soltanto la quantità, ma anche la natura sistemica di questa tendenza, che riguarda ormai tutti i principali modelli e che investe differenti categorie tematiche: politica, notizie, salute e attualità.
Il problema delle risposte convincenti ma errate
Un problema particolarmente insidioso delle risposte errate generate dai sistemi di AI risiede nella loro capacità di apparire convincenti e autorevoli. Le affermazioni sbagliate vengono frequentemente presentate con sicurezza, sfruttando una formulazione raffinata e un tono che simula l'affidabilità di un esperto. Questo fenomeno complica il compito degli utenti, che rischiano di accettare informazioni false come veritiere senza ulteriori verifiche.
L'autorevolezza percepita non corrisponde necessariamente all'autorevolezza reale: il modello non distingue tra ipotesi e fatto, tra fonte verificata e opinione infondata. Emerge così il problema sistemico della fiducia mal riposta nelle tecnologie, soprattutto in contesti in cui le decisioni hanno un impatto rilevante (giustizia, salute, lavoro):
- L'assenza di indicatori di incertezza o di rassicurazioni sulla qualità delle fonti porta l'utente a sottovalutare i rischi.
- L'immediatezza e la fluidità delle risposte rafforzano falsamente la percezione di correttezza.
Allucinazioni, bias e fonti inaffidabili: errori tipici e rischi
I principali errori delle intelligenze artificiali possono essere classificati in tre categorie:
- Allucinazioni: il chatbot, non trovando la risposta nei dati posseduti, inventa informazioni plausibili. Il fenomeno riguarda sia nozioni storiche che attualità e può portare a suggerimenti del tutto privi di riscontro.
- Bias nei dataset: pregiudizi incorporati nei dati (di tipo culturale, sociale o di genere) vengono riprodotti automaticamente, generando discriminazioni sistemiche.
- Fonti inaffidabili: la possibilità di attingere informazioni dal web in tempo reale espone le AI a contenuti generati da altri sistemi automatici, siti poco attendibili o addirittura campagne organizzate di disinformazione, aumentando sia il rischio di errore che quello di manipolazione.
Le differenze tra l'IA e il ragionamento umano
Nonostante la crescente sofisticazione dei modelli, l'intelligenza artificiale non raggiunge la reale capacità di ragionamento umano. L'essere umano applica euristiche, intuizioni e filtri di senso che permettono di distinguere il verosimile dal falso anche in situazioni di incertezza o ambiguità; invece, i sistemi automatici si limitano a ricercare la risposta più probabile secondo criteri statistici, senza aggiungere esperienza né interpretazione personale.
Nel riconoscimento delle immagini, ad esempio, basta un piccolo cambiamento per confondere la macchina, mentre una persona è in grado di apprendere per analogia e adattarsi a eccezioni grazie all'esperienza diretta. Anche di fronte a domande che richiedono intuizione o comprensione del contesto, il divario rimane marcato.



Marcello Tansini
Nato a Milano nel 1979, laureato alla Bocconi dopo il liceo classico ai Salesiani di Milano. Uno dei pionieri dell'Internet italiano, uno dei fondatori tra l'altro del celebre sito degli anni 90-2000 webmasterpoint.org, si occupa di organizzare tutta la parte editoriale di Businessonline, ma scrive anche lui stesso sia sulle tematiche legate ai suoi studi che alle sue passioni. In modo particolar...
 Seguici su Google News cliccando qui e poi fai click sulla Stellina in alto a destra