Un AirTag nascosto tra le pagine di un libro raro ha percorso migliaia di chilometri attraverso gli Stati Uniti e si è fermato in un magazzino Amazon a Las Vegas, rivelando una delle conferme più concrete mai ottenute su come i grandi colossi dell'intelligenza artificiale acquisiscono contenuti protetti da copyright
Un AirTag nascosto tra le pagine di un libro raro ha percorso migliaia di chilometri attraverso gli Stati Uniti e si è fermato in un magazzino Amazon a Las Vegas. Quello che ha rivelato è una delle conferme più concrete mai ottenute su come i grandi colossi dell'intelligenza artificiale acquisiscono contenuti protetti da copyright: comprano libri fisici, li smontano, li scansionano e li buttano via.
Un libraio, mille libri e un localizzatore nascosto
Tutto inizia con un ordine insolito. Un acquirente anonimo contatta un libraio indipendente e gli commissiona l'acquisto in blocco di circa mille volumi, molti dei quali rari o fuori catalogo. Niente di illegale in apparenza, solo un cliente con un budget generoso e un interesse molto specifico per testi difficili da trovare.
Il libraio, però, ha i suoi sospetti. E quando la redazione investigativa di 404 Media lo avvicina con una proposta, decide di collaborare. Il piano è semplice quanto efficace: nascondere un Apple AirTag tra le pagine di uno dei libri spediti, e poi aspettare.
Il localizzatore parte insieme alla partita. Per alcune settimane rimane in movimento, attraversando diversi stati americani. Poi si ferma. La destinazione finale è un magazzino Amazon situato a Las Vegas, Nevada.
Cosa succede dentro il magazzino: il reparto VGT3
Quel magazzino non è un normale centro di distribuzione. I dipendenti che ci lavorano lo chiamano con un nome specifico: VGT3. E il lavoro che si svolge lì dentro non ha niente a che fare con la spedizione di pacchi ai clienti.
Secondo le testimonianze raccolte da 404 Media, la routine del reparto è sempre la stessa:
Qualcuno riceve le partite di libri e legge i codici a barre. È la prima fase, quella di identificazione e catalogazione del materiale in arrivo.
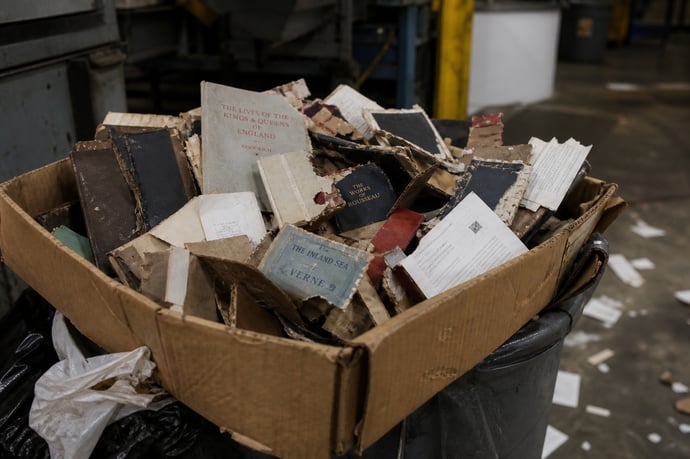
Qualcun altro taglia. Non metaforicamente: i lavoratori rimuovono fisicamente le coste dei libri con apposite attrezzature. La rilegatura viene separata dal blocco delle pagine perché lo scanner industriale presente nel reparto lavora molto più velocemente su fogli sciolti che su volumi rilegati.
Le pagine passano sotto lo scanner. Il contenuto viene acquisito digitalmente, presumibilmente in alta risoluzione, per essere poi processato e utilizzato come dato di addestramento per sistemi di intelligenza artificiale.
I resti vengono buttati via. Quello che rimane dopo la scansione, ovvero la copertina, la costa, la rilegatura e qualsiasi altro elemento non utile alla digitalizzazione, finisce nella spazzatura.
Il libro originale, spesso un'opera rara e di valore, cessa di esistere come oggetto fisico. Al suo posto rimane solo una copia digitale destinata ad addestrare modelli di linguaggio o altri sistemi AI.
Perché questa scoperta è così importante
Da anni circola la voce che le grandi aziende tecnologiche, in particolare quelle impegnate nello sviluppo di intelligenza artificiale generativa, utilizzino testi protetti da copyright per addestrare i propri modelli senza ottenere le necessarie autorizzazioni dagli autori o dagli editori.
Fino ad oggi, però, le prove erano perlopiù indirette: analisi statistiche sui dataset, dichiarazioni di ex dipendenti, cause legali basate su indizi. Con l'AirTag nel libro raro, per la prima volta si ha una prova fisica e tracciabile di un intero processo: dall'acquisto anonimo di volumi, al trasporto, fino alla distruzione del materiale dopo la digitalizzazione.
Non si tratta di un dataset scaricato da internet. Non si tratta di una copia pirata che circola su qualche forum. Si tratta di libri acquistati, pagati, spediti fisicamente e poi smontati pezzo per pezzo all'interno di una struttura che, secondo le testimonianze dei lavoratori, esiste proprio per questo scopo.
Il contesto legale: autori ed editori sotto attacco
Questa vicenda arriva in un momento già molto teso sul fronte dei diritti d'autore nell'era dell'AI. Numerosi autori, tra cui alcuni tra i più noti scrittori americani, hanno avviato cause legali contro OpenAI, Meta, Google e altri sviluppatori di modelli linguistici, accusandoli di aver utilizzato le loro opere senza consenso e senza compenso.
Gli editori tradizionali, da Penguin Random House a HarperCollins, stanno cercando di costruire accordi commerciali con le aziende AI per ottenere licenze regolari sull'uso dei contenuti. Alcune trattative sono in corso, altre si sono già concluse con accordi riservati.
Nel frattempo, però, emerge che almeno una parte dell'acquisizione di contenuti avviene attraverso canali fisici e deliberatamente opachi: acquisti anonimi in blocco, spedizioni anonime, smaltimento del materiale dopo l'uso.
Chi ha ordinato quei mille libri al libraio? L'identità dell'acquirente non è stata resa nota, ma il collegamento con Amazon, uno dei principali investitori e sviluppatori di sistemi AI attraverso la divisione AWS e i propri modelli Bedrock, è documentato dall'AirTag.
Amazon e il silenzio delle aziende
Contattata da 404 Media, Amazon non ha rilasciato dichiarazioni dettagliate sull'esistenza o sulle attività del reparto VGT3. Questo silenzio è già di per sé eloquente: nessuna smentita, nessuna spiegazione alternativa, nessun tentativo di contestare la ricostruzione.
Nel settore AI è prassi consolidata non commentare le fonti dei dati di addestramento. Le aziende si limitano a dichiarare genericamente di rispettare le leggi sul copyright, senza entrare nel merito delle pratiche operative. Questo approccio diventa sempre più difficile da sostenere quando emergono prove concrete come quella dell'AirTag.
Cosa significa per autori, editori e librai
Per chi lavora nel mondo del libro, questa storia ha implicazioni pratiche immediate.
I librai indipendenti si trovano in una posizione paradossale: possono ricevere ordini generosi da acquirenti anonimi che pagano bene e senza contrattare. Rifiutare significa perdere una fonte di guadagno. Accettare significa potenzialmente contribuire a un sistema che erode il valore dei contenuti su cui si basa la loro stessa attività.
Gli autori vedono confermato il peggiore dei loro timori: non si tratta solo di dataset digitali raccolti online, ma di una caccia sistematica anche ai testi fisici, compresi quelli rari, fuori catalogo, difficilmente reperibili in formato digitale e quindi non raggiungibili con una semplice scansione del web.
Gli editori devono fare i conti con un mercato secondario che, almeno in parte, potrebbe essere alimentato da acquisti finalizzati alla digitalizzazione massiva. Libri che escono dai circuiti tradizionali non per finire nelle mani di lettori, ma in uno scanner industriale.
Cosa succederà adesso
La vicenda ha già fatto il giro delle principali testate tecnologiche internazionali e alimenterà quasi certamente nuove discussioni nei procedimenti legali in corso. Gli avvocati che rappresentano autori ed editori nelle cause contro le aziende AI avranno ora a disposizione un caso concreto da citare come esempio di acquisizione sistematica di contenuti protetti.
Sul fronte regolatorio, sia negli Stati Uniti che in Europa, il dibattito sull'uso dei dati di addestramento è già aperto. L'AI Act europeo e le proposte legislative americane includono disposizioni sul copyright e sull'obbligo di trasparenza sulle fonti dei dati, ma i tempi di applicazione sono ancora incerti.
Nel frattempo, i libri continuano ad arrivare al magazzino di Las Vegas. Le coste vengono tagliate. Le pagine passano sotto lo scanner. E quello che resta finisce nella spazzatura.


Chiara Compagnucci
Nata a Roma nel Giugno del 1978, effettua gli studi di ragioniere e si appassiona al tennis. Amante del mondo delle quattro ruote e delel due ruote, è sempre curiosa su tutte le novità delle case automobilistiche e sulle nuove auto in uscita. Scrive da anni per diversi blog ed ora si dedica a tempo pieno su questo sito web trattando in particolar modo tematiche sul mondo delle auto e sugli argomen...
 Seguici su Google News cliccando qui e poi fai click sulla Stellina in alto a destra