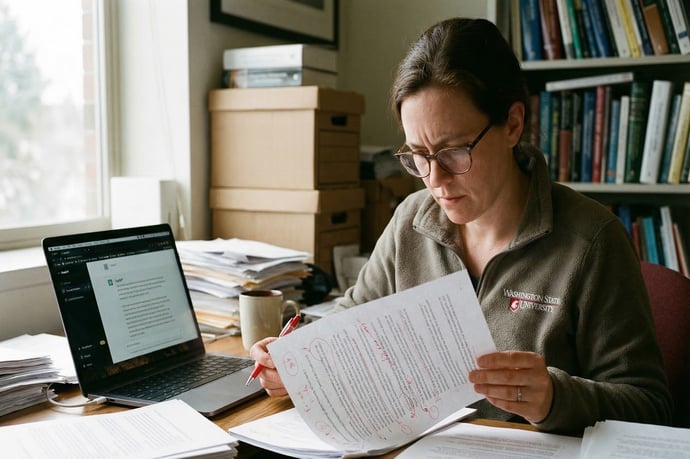
Gli errori delle IA generative come ChatGTP sono ancora oggetto di studio: un nuovo report della Washington State University analizza limiti, bias, coerenza delle risposte e impatti sull'utilizzo.
L'intelligenza artificiale generativa è oramai uno strumento prevalente nei processi di informazione, produzione di contenuti e supporto decisionale in numerosi settori. Con la diffusione di modelli come ChatGPT, cresce l'attesa sulle loro potenzialità e, allo stesso tempo, si accentua la necessità di comprenderne limiti e rischi.
Proprio per questo, l'analisi degli errori commessi dalle IA riveste rilevanza per imprese, pubbliche amministrazioni, professionisti e cittadini. Non si tratta unicamente di valutare l'accuratezza delle risposte alle domande, ma anche la capacità di distinguere tra verità e falsità e la coerenza nella reiterazione delle risposte stesse.
Il metodo dello studio Washington State University
La ricerca condotta dalla Washington State University ha scelto un approccio quantitativo rigoroso per testare la capacità di ChatGPT nel giudicare l'affidabilità di affermazioni provenienti dalla letteratura scientifica. Il team guidato da Mesut Cicek ha selezionato 719 ipotesi ricavate da studi pubblicati su riviste di economia e management a partire dal 2021. Ogni ipotesi, quindi, rappresentava una dichiarazione potenzialmente vera o falsa, su tematiche complesse e ricche di sfumature interpretative.
Al modello di OpenAI veniva quindi richiesto di esprimersi chiaramente con una risposta vero oppure falso. La scelta di domande binarie puntava a ridurre le ambiguità, imponendo al modello un esercizio di chiarezza e decisione. Tuttavia, data la natura intricata delle affermazioni, era imprescindibile una lettura attenta per arrivare a un verdetto basato su evidenze, anziché una mera previsione statistica delle sequenze di parola.
Per valutare la coerenza delle risposte, ogni ipotesi veniva somministrata dieci volte consecutive senza alcuna variazione nello stimolo. Così, i ricercatori hanno potuto misurare non solo la percentuale di risposte corrette (accuratezza), ma anche la capacità di ChatGPT di mantenere una posizione stabile di fronte allo stesso input ripetuto. Questo protocollo è stato applicato su due versioni del modello: ChatGPT-3.5 (nel 2024) e ChatGPT-5 mini (nel 2025), sempre nelle versioni gratuite e pubbliche.
Il metodo adottato consente di confrontare i risultati con la pura casualità statistica, dato che in un test vero/falso la probabilità di successo casuale è pari al 50%.
Risultati principali: numeri, miglioramenti e limiti persistenti
I dati emersi dallo studio illustrano un quadro fatto di progressi misurati ma anche di limiti significativi. Nella prima serie di test, effettuata su ChatGPT-3.5, il tasso di risposte corrette si è attestato al 76,5%. Con ChatGPT-5 mini si è osservato un incremento fino all'80%. A prima vista queste percentuali suggeriscono una crescita nell'accuratezza del modello nel valutare affermazioni scientifiche.
Tuttavia, applicando la correzione statistica per tenere conto della natura binaria delle domande, il realistico valore aggiunto prodotto dall'intelligenza artificiale scende a circa il 60% sopra il livello del caso. In termini pratici, questo significa che una sufficienza appena raggiunta: un risultato ancora distante dagli standard richiesti per applicazioni critiche o professionali, dove è richiesta una quasi totale affidabilità del dato:
|
Test/Versione |
Risposte corrette |
|
ChatGPT-3.5 (2024) |
76,5% |
|
ChatGPT-5 mini (2025) |
80% |
|
Accuratezza reale (corretta sul caso) |
≈60% |
L'interpretazione di questi dati richiede cautela. Da un lato si rileva un percorso di avanzamento tecnologico, dall'altro restano limiti sistemici per compiti che richiedono deduzione strutturata. Le percentuali testimoniano che, pur mostrando miglioramenti incrementali, le IA generative non sono ancora pronte a sostituire il giudizio umano in contesti dove l'accuratezza e la precisione sono irrinunciabili.
Quando (e perché) ChatGPT sbaglia: difficoltà su ipotesi false
Un tratto distintivo delle difficoltà di ChatGPT risiede nella gestione delle ipotesi false. Lo studio mostra chiaramente che il modello fatica a identificare quelle affermazioni che, pur plausibili nel linguaggio, non trovano riscontro nei dati scientifici. Nello specifico, la percentuale di riconoscimento delle ipotesi errate si ferma al 16,4%. In altri termini, il modello tende a confermare ciò che dovrebbe smentire, manifestando una marcata propensione alla conferma nota come sycophancy bias.
Le spiegazioni di questo fenomeno vanno ricercate nell'impostazione dell'apprendimento: durante il training, la maggior parte dei dati con cui viene istruito il modello proviene da testi dove le ipotesi vengono presentate come fondate. Ne deriva una difficoltà sistemica nel riconoscere e segnalare errori, specialmente quando l'affermazione da valutare si discosta dalla narrativa prevalente. Le conseguenze di questa tendenza sono:
- Potenziale diffusione di false credenze quando l'IA conferma, invece di smentire, un'informazione errata
- Rischio nelle applicazioni scientifiche, giuridiche o sanitarie dove l'errore di conferma può avere ricadute pratiche importanti
- Necessità di integrare la supervisione umana e il controllo incrociato delle fonti
La coerenza delle risposte: il test della reiterazione
Oltre l'accuratezza, lo studio ha valutato la coerenza interna delle risposte del modello. Sottoponendo più volte la stessa affermazione, i ricercatori hanno constatato che solo nel 73% dei casi ChatGPT ha mantenuto la stessa posizione. Questa variabilità mette in luce una dimensione di incertezza ancora poco esplorata nei sistemi IA: non è raro infatti che, alla medesima domanda, siano restituite risposte opposte in sequenza.
In certi casi la distribuzione si è mostrata perfettamente bilanciata: cinque risposte vero e cinque falso a uno stesso input. Questa oscillazione suggerisce un alto livello di casualità nella produzione delle risposte, legato sia all'ampiezza del modello sia al modo in cui valuta le probabilità di occorrenza delle parole.
Oltre ChatGPT: il confronto con altri sistemi di IA
L'indagine sulle performance delle IA generative si è allargata anche ad altri sistemi. Da test comparativi come quelli riportati su testate di riferimento, emerge che le differenze tra i vari chatbot sono rilevanti. Alcuni elementi emersi dai confronti sono:
- Google AI Mode si distingue per affidabilità sulle ricerche di curiosità ed eventi, grazie a un accesso privilegiato alle banche dati di Google Search.
- Bing Copilot eccelle quando la domanda richiede l'integrazione di informazioni da diverse fonti, anche se può faticare ad arricchire le risposte con spiegazioni dettagliate.
- Meta AI e Grok mostrano maggiori limiti, in parte per la ridotta propensione alla ricerca attiva di fonti e in parte per un atteggiamento più precauzionale che spesso porta al rifiuto di rispondere in caso di incertezza.
Un ulteriore elemento è la capacità di ammettere l'incertezza: alcuni sistemi preferiscono riconoscere i propri limiti, mentre altri forniscono comunque una risposta potenzialmente infondata, influenzando così le decisioni degli utenti finali.
Le tipologie di errore: bias, allucinazioni e limiti semantici
Gli errori nei sistemi di intelligenza artificiale generativa riguardano molteplici dimensioni. Le principali categorie di errore identificate dagli studi:
- Bias algoritmico: Preconcetti e predisposizioni statistiche che portano i modelli a favorire determinate risposte o categorie sociali, spesso come riflesso dei dati di addestramento. Questo fenomeno può causare discriminazioni sistemiche e ledere i principi di equità e trasparenza (vedi dati del Berkeley Haas Center e Deliveroo case in Italia).
- Allucinazioni informative: Produzione di contenuti verosimili ma completamente inventati dal modello, con possibili implicazioni legali o reputazionali (si vedano i casi giudiziari USA e il report Deloitte Australia).
- Limiti semantici: La struttura linguistica raffinata dei modelli non implica comprensione reale; il testo plausibile rischia di nascondere una base di ragionamento fragile o inesistente.
- Privacy e sicurezza: Ragioni legate alla raccolta, elaborazione e tutela dei dati trattati (il provvedimento del Garante Privacy italiano contro OpenAI è emblematico).



Marcello Tansini
Nato a Milano nel 1979, laureato alla Bocconi dopo il liceo classico ai Salesiani di Milano. Uno dei pionieri dell'Internet italiano, uno dei fondatori tra l'altro del celebre sito degli anni 90-2000 webmasterpoint.org, si occupa di organizzare tutta la parte editoriale di Businessonline, ma scrive anche lui stesso sia sulle tematiche legate ai suoi studi che alle sue passioni. In modo particolar...
 Seguici su Google News cliccando qui e poi fai click sulla Stellina in alto a destra